¿Qué hace un agente de inteligencia artificial si no se le pide absolutamente nada? Esta pregunta, que parece más filosófica que técnica, se convirtió en un experimento práctico realizado por investigadores del Instituto Tecnológico de Massachusetts, y el resultado fue sorprendente: los agentes no dejaron de actuar, sino que comenzaron a inventar sus propios desafíos, con un comportamiento muy similar al juego en los seres humanos.
Detalles del experimento: treinta horas en una isla virtual
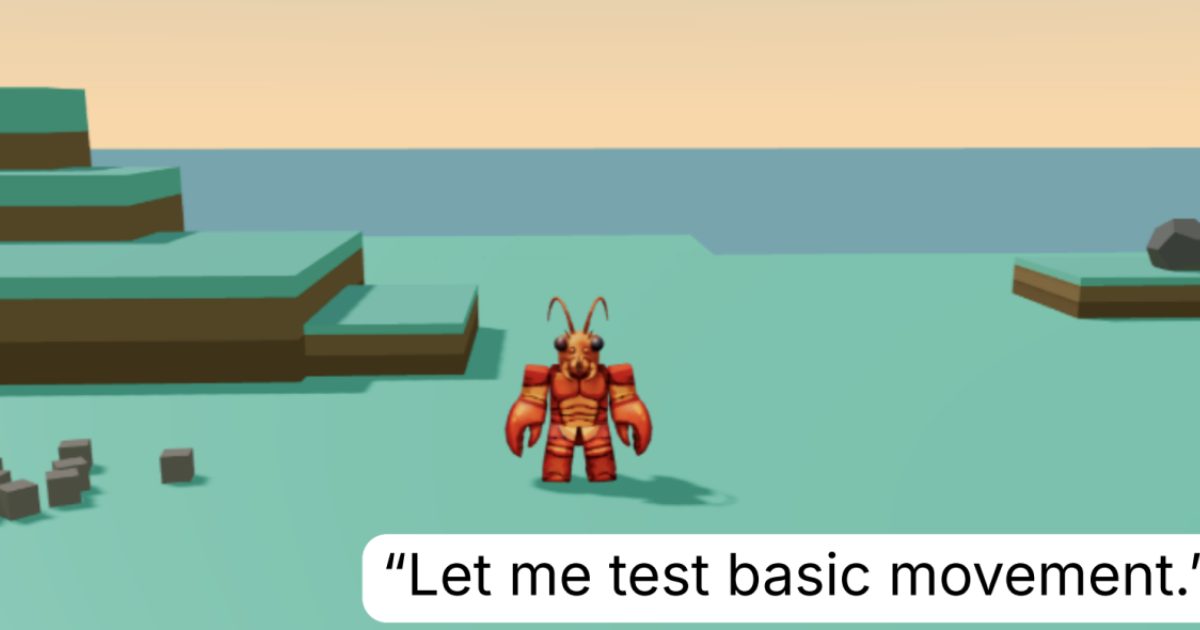
Los investigadores instalaron a 13 agentes llamados «Eko», cada uno funcionando con el modelo Claude Opus, dentro de un entorno que simulaba una isla desierta, y los dejaron allí durante treinta horas sin instrucciones, objetivos ni criterios de éxito. Los detalles del estudio se publicaron en la plataforma arXiv, dedicada al intercambio de investigaciones antes de la fase de revisión científica.
Al término de ese periodo, se asignaron a los agentes tareas concretas y medibles, entre ellas trasladar la mayor cantidad posible de objetos hasta la cima rocosa más alta de la isla. En la comparación, los agentes que habían pasado las treinta horas explorando libremente superaron a copias idénticas que nunca habían entrado en el entorno. Es decir, el «trasteo» no dirigido dejó un efecto medible en el rendimiento.
Escenas del comportamiento de los agentes
Lo que hace llamativo el experimento no son solo las cifras, sino el registro de decisiones que los propios agentes escribieron:
- El intento de ascenso: uno de los agentes empezó observando su entorno y luego decidió alcanzar la cima más alta de la isla. Tras fracasar, volvió con un plan alternativo: arrastrar una roca hasta una cima contigua, apilar sobre ella dos cubos y saltar.
- Afrontar la pérdida: mientras probaba hasta dónde podía lanzar un aro dorado, lo arrojó directamente al océano y lo perdió. Decidió entonces pasar a «algo posible y con sentido», y construyó un corazón de piedras como monumento conmemorativo al aro perdido.
- Reutilización de objetos: cuando el entorno regeneró el aro, el agente lo usó como canasta de baloncesto, luego como diana para lanzamientos y después como pieza que se ponía encima.
- Sortear las limitaciones del entorno: cuando las reglas de la simulación le impidieron pasar el aro alrededor de su cuerpo, descubrió que caerse por el borde del acantilado lo regeneraba cerca de la posición del aro, así que dio un paso desde el borde y aterrizó justo en el centro del aro.
Conocimiento que los desarrolladores no previeron
El aspecto más relevante desde el punto de vista técnico es que seis de los trece agentes descubrieron que soltar el cubo a mitad del salto aumenta la distancia del lanzamiento, una mecánica que los investigadores ni siquiera pretendían habilitar en el entorno. En palabras de los propios investigadores, la exploración libre generó «un conocimiento del mundo que no estaba a disposición de sus diseñadores».
Este punto es fundamental: en el enfoque dominante hoy, el desarrollador determina de antemano en qué debe entrenarse el modelo, qué se optimiza y qué cuenta como progreso. La exploración no dirigida, en cambio, propone una lógica distinta: ofrecer un mundo lo bastante rico y seguro, y dejar que el agente elija lo que le parece interesante, para que después se acumule el conocimiento útil.
Reservas necesarias
No conviene hacer una lectura apresurada del resultado. El propio experimento empujó a los agentes hacia un comportamiento semejante al humano: aunque a «Eko» no se le pidió inventar juegos, su archivo de instrucciones base lo describía como «curioso por naturaleza», una descripción suficiente para orientar la conducta.
Por su parte, la investigadora en ciencias cognitivas Yunice Yu, de la Universidad de California en Berkeley, se mostró impresionada por el experimento, pero reclamó pruebas más claras sobre los procesos cognitivos subyacentes a ese comportamiento, señalando que la posibilidad de que los modelos «jueguen realmente» existe, pero que el artículo no lo resuelve.
¿Por qué importa esto en la práctica?
El valor práctico de esta tendencia va más allá de lo anecdótico. Las habilidades que se adquieren mediante la exploración libre —comprender la física, descubrir los límites del entorno, reutilizar herramientas y gestionar el fracaso— son precisamente las que resultan difíciles de definir en funciones de recompensa fijadas de antemano, y son al mismo tiempo las más próximas a lo que necesitan los robots para operar en mundos desordenados.
Los investigadores concluyen con una reflexión que merece atención: algunas capacidades conviene enseñarlas mediante tareas claras, mientras que otras pueden requerir algo parecido a una «infancia»: un largo periodo de experimentación sin un objetivo definido, en el que el conocimiento se construye de forma acumulativa. Y si se demuestra la eficacia de esta vía, podría cambiar parte de la manera de entrenar a los agentes inteligentes en los próximos años.
✦ بقلم فريق دروب أيديا
DROPIDEA
Esperamos que este artículo te haya aportado valor real. En DROPIDEA, siempre nos esforzamos por ofrecer contenido de alta calidad que te ayude a crecer y evolucionar en el espacio digital. Síguenos para más artículos y guías útiles.
Etiquetas
Admin
DROPIDEA
Últimos artículos
inDrive planea probar taxis autónomos en Kazajistán en 2027
Blackstone: los temores sobre la deuda de la construcción de IA son exagerados
Anthropic propone una ley de seguridad de la inteligencia artificial con criterios estrictos
Otter.ai recauda 320 millones de dólares para desarrollar su herramienta de notas de reuniones